Da vent'anni il mio BeeBEEP porta testo e file. BeeBEEP 5 non ha le chiamate; il nuovo BeeBEEP le avrà. Prima di scrivere una riga della chiamata c'era una domanda a cui rispondere: un messenger senza server può portare piccoli pacchetti che non valgono nulla se arrivano tardi? Un messaggio di chat può aspettare un secondo. Una voce no: venti millisecondi di voce che arrivano dopo il loro turno vengono buttati via. Questa è la storia di cosa è stato difficile, cosa ho scelto e cosa abbiamo buttato via. Scrivo "noi" dove il lavoro è stato fatto insieme: il nuovo BeeBEEP lo sto costruendo con Claude.
Una domanda prima del codice
Così il primo lavoro non è stato l'audio. È stata una misura della strada di rete che la chiamata avrebbe usato, con pacchetti sintetici della dimensione e del ritmo di una voce (60 byte, cinquanta al secondo) e una rete simulata che aggiunge 20 ms per verso e perde pacchetti.
| Perdita per verso | UDP, p50 / p99 | TCP, p50 / p99 |
|---|---|---|
| 0 % | 20 / 21 ms | 21 / 21 ms |
| 1 % | 20 / 21 ms | 21 / 81 ms |
| 5 % | 20 / 21 ms | 21 / 321 ms |
UDP dà il ritardo del collegamento qualunque sia la perdita, e perde quello che perde. TCP non perde nulla e paga in coda: una ritrasmissione trattiene tutti i pacchetti dietro di sé. Così la chiamata viaggia su UDP, su un suo "canale dal vivo" accanto alla connessione normale, e TCP è solo il ripiego quando UDP non passa.
La prima volta questa tabella era peggiore per TCP: 41 ms alla mediana senza perdite. Si è scoperto che ogni connessione di BeeBEEP aveva attivo l'algoritmo di Nagle. Era un difetto a sé, corretto prima di andare avanti.
Cosa ho scelto
- La chiamata è un plugin. Arriva con BeeBEEP su ogni piattaforma, ma resta un plugin, del tipo che hai conosciuto in Una casa per i plugin: l'interfaccia dei plugin si tiene il suo utente più esigente, e le librerie audio restano fuori dal client e dal relay. Un amministratore può spegnere le chiamate.
- Librerie messe insieme, non tutto WebRTC. Opus per la voce, Ogg per i messaggi vocali, e di WebRTC solo la sua libreria di elaborazione dell'audio: la cancellazione dell'eco (AEC3), la riduzione del rumore, il controllo del guadagno. Le compiliamo noi da sorgenti fissate, perché alcune distribuzioni Linux ne hanno versioni troppo vecchie (Opus 1.3.1, una libreria di elaborazione senza AEC3).
- Anche i messaggi vocali sono passati a Opus, sulle stesse librerie. A un BeeBEEP 5 un messaggio vocale arriva ancora come WAV, che sa riprodurre.
Misurare una chiamata in cui nessuno parla
Una chiamata è difficile da misurare a orecchio, e impossibile da misurare due volte allo stesso modo. Per questo BeeBEEP ha un microfono sintetico e un altoparlante sintetico. Il microfono "parla": un suono simile a una voce con dentro dei brevi segni, ognuno un impulso di 30 ms che l'altra parte sa riconoscere. Il tempo fra un segno che lascia un microfono e il suo arrivo all'altro altoparlante è il ritardo dalla bocca all'orecchio. Due istanze, due spazi di rete separati, una rete simulata fra loro, e una chiamata si può ripetere quante volte si vuole nelle stesse condizioni.
La prima chiamata misurata, ancora senza cancellazione dell'eco: da 85 a 115 ms dalla bocca all'orecchio alla mediana, con perdite fino all'1 %.
Anche lo strumento a volte mente, e vale la pena dirlo. Con due voci sintetiche che facevano segni identici allo stesso ritmo, la cancellazione dell'eco ha "trovato" un'eco lunga 412 ms dove non ce n'era nessuna: nessuna voce vera è l'onda dell'altra mezzo secondo dopo. Abbiamo provato segni a istanti casuali, e si sono scontrati. Uno strumento di misura va giudicato come il codice che misura.
Il suono su un desktop
La parte più difficile non è stata la rete. È stato il server audio di un desktop Linux (PipeWire) e quello che succede fra Qt e lui.
- Un buffer più piccolo del quanto del server affama il flusso. Avevamo chiesto buffer di 20 ms, per tenere basso il ritardo. Il quanto predefinito di PipeWire è di 1024 campioni, 21,3 ms. Il risultato: l'altoparlante suonava a circa metà del tempo reale, circa il 40 % dei pacchetti veniva scartato perché in ritardo, e il microfono consegnava il 7 % di pacchetti in meno del dovuto.
- Una richiesta di 170 ms che non lo era. La prima diagnosi diceva che il server audio chiedeva 170 ms di suono alla volta. Era il buffer di lettura di Qt, di 16 KB, in mezzo, che trasformava una richiesta piccola in 85 ms di campioni suonati in ritardo.
- La riproduzione con un orologio suo. Fino ad allora l'altoparlante chiedeva e la chiamata riempiva. Ora la chiamata scrive a un battito regolare di 10 ms in un anello, e l'altoparlante lo svuota al ritmo che preferisce. I due orologi si allontanano; lo scarto è assorbito a battiti interi, mai ricampionando.
- Ogni dispositivo ricorda cosa ha funzionato. I buffer partono da 20 ms e crescono dove un dispositivo ne ha bisogno, e quello che è servito a un dispositivo viene ricordato per la chiamata dopo. La prima chiamata su un dispositivo nuovo paga una volta, le successive partono giuste.
L'eco
Senza cuffie, la voce dell'altra persona esce dall'altoparlante e rientra nel microfono. La cancellazione dell'eco impara quel percorso e lo toglie: nelle nostre prove di 33-35 dB, con un'eco in ritardo di 60, 120 o 400 ms, e trova il ritardo da sola anche quando gliene viene detto uno sbagliato.
Ha un costo. L'elaborazione dell'audio aggiunge 15 ms dalla bocca all'orecchio: 9 per la cancellazione dell'eco, 7 per la riduzione del rumore, 1 per il filtro passa-alto. Ogni client WebRTC paga lo stesso.
Due scelte le ho fatte su suoni veri:
- La riduzione del rumore resta attiva, su "alta". La mia cuffia ha un ronzio a 50 Hz con le sue armoniche. Il solo filtro passa-alto toglie 15 dB ai 50 Hz e quasi nulla al resto; la riduzione su "alta" toglie circa 24 dB nel complesso. Spegnerla restituirebbe 7 ms, e con loro il ronzio.
- Il guadagno parte da 0 dB, non da 15. Con 15 dB dal primo campione, una voce che comincia forte finisce nel limitatore finché il controllo del guadagno non ha sentito abbastanza per abbassarlo.
E una scelta è stata di non cambiare nulla. Mentre le due persone parlano insieme, la cancellazione dell'eco trattiene la voce vicina finché non ha imparato la stanza; con le cuffie, finché non ha deciso che l'eco non c'è affatto, e può volerci fino a un minuto. Potremmo regolarne l'interno. Ho deciso di no: regolare una cancellazione dell'eco scambia un difetto con un altro, un'eco che filtra o una voce che viene mangiata, e i browser la usano così com'è. La giudicherò a orecchio, in chiamate vere.
Un'idea misurata e buttata via
Con un quanto grande (8192 campioni, 170 ms: un profilo di risparmio energetico, o certe cuffie Bluetooth) il microfono consegna 170 ms di suono in una volta. La chiamata codifica e spedisce otto o nove pacchetti uno dietro l'altro, poi niente per 170 ms. L'altra parte sembrava restare a secco fra una raffica e l'altra.
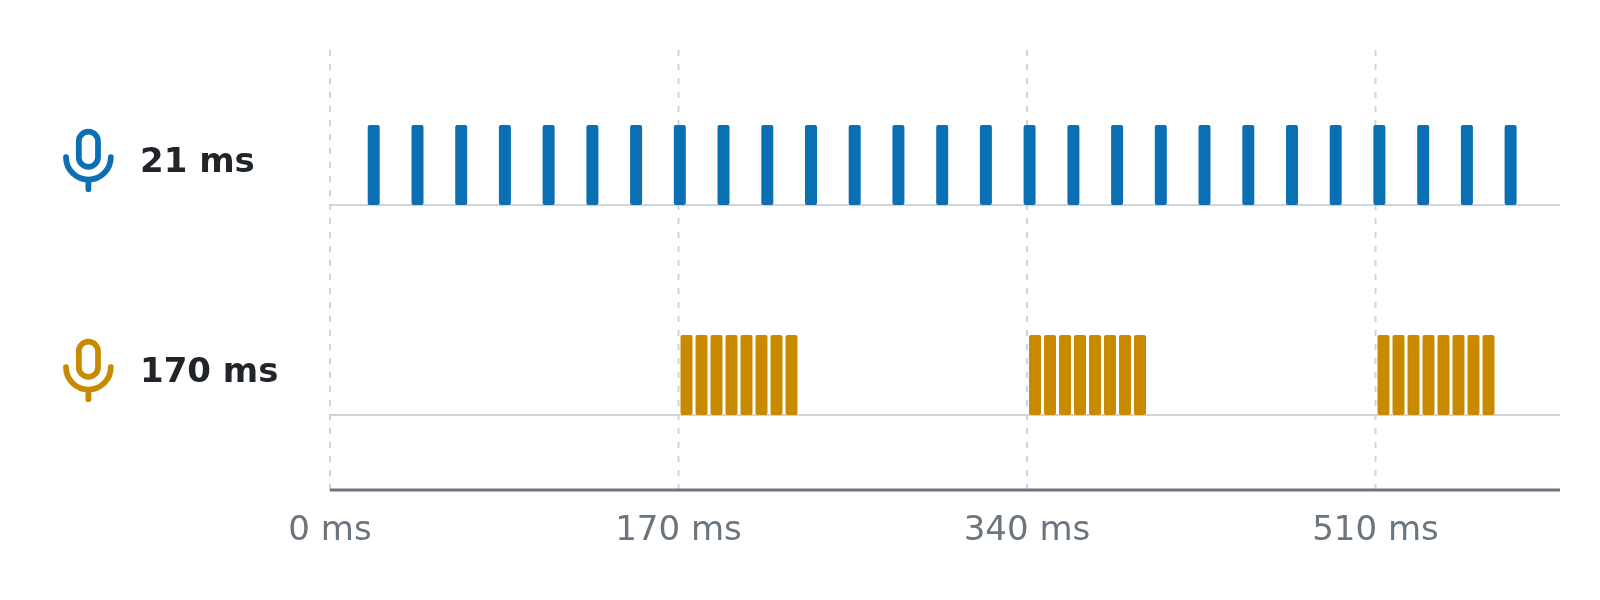
La soluzione ovvia era dare un ritmo alla spedizione: passare i pacchetti alla rete con un orologio di 10 ms, come fa la riproduzione dall'altra parte. L'abbiamo costruita e misurata. Aggiungeva da 20 a 60 ms di ritardo e non dava nulla di misurabile. Una seconda misura, con il microfono sintetico che consegnava le stesse raffiche, ha mostrato che le raffiche da sole costano ritardo, non pacchetti persi. La spedizione a ritmo non è stata tenuta.
Cosa fa Telegram
Prima di decidere cosa fare invece, abbiamo letto come Telegram ha risolto gli stessi problemi, nel suo codice
pubblico: la sua libreria per le chiamate tgcalls, la sua versione di WebRTC, l'audio di Telegram
Desktop e il motore più vecchio, libtgvoip. Le sue scelte sono fatte per la sua rete, l'internet
mobile; le nostre devono esserlo per la nostra, la LAN.
- Il tempo su un pacchetto è quello della voce, non quello della rete. In WebRTC il timestamp di un pacchetto audio conta i campioni, e il jitter buffer misura l'arrivo di ogni pacchetto rispetto a quello; il motore più vecchio di Telegram faceva lo stesso con un suo contatore. Una raffica allora sembra jitter, il buffer cresce per coprirla, e non resta a secco. I nostri pacchetti portavano l'ora in cui erano partiti, ammassata come il loro arrivo, così l'altra parte non vedeva alcun jitter e restava alla sua misura più piccola. È questo che ho deciso di cambiare: il jitter buffer dell'altra parte imparerà dall'orologio del microfono.
- Nessuno dà un ritmo alla spedizione. Telegram Desktop prende ogni pezzo di 10 ms che il microfono ha raccolto, uno dopo l'altro, come fa il nostro.
- La cancellazione dell'eco non viene regolata. Telegram usa l'elaborazione dell'audio di WebRTC con la sua configurazione predefinita. Su iPhone la cancellazione software è spenta e fa il lavoro l'elaborazione della voce di Apple; su Android il motore più vecchio usava quella del telefono quando c'era, la sua altrimenti. È la regola che avevo già scelto per i telefoni.
- Anche lì il ritardo detto alla cancellazione dell'eco è una stima. Su Linux e macOS Telegram Desktop le dice 20 ms fissi dal lato del microfono e la lascia trovare l'eco vera. Lo stesso facciamo noi.
- Più ritardo, per scelta. Le chiamate di Telegram usano pacchetti Opus di 60 ms e un jitter buffer che non scende mai sotto i 50 ms: sull'internet mobile la robustezza vale più di 50 ms. Le chiamate di BeeBEEP partono da una LAN, con pacchetti di 20 ms e un minimo di 40 ms.
Allora tutto WebRTC risolverebbe i nostri problemi? Delle quattro domande aperte ne risolve una, con un'idea che possiamo prendere senza di lui. Alle altre risponde come facciamo già noi, o con più ritardo, al prezzo di un grosso fork da mantenere su cinque piattaforme. Quello che ha e noi no è un modo più delicato di correggere lo scarto degli orologi dentro la voce; il nostro lo ascolterò in chiamate vere.
Un limite, letto bene
La regola abituale per una chiamata è di 150 ms dalla bocca all'orecchio: la raccomandazione ITU-T G.114 lo chiama "trasparente", e fino a 400 è ancora accettabile. Con l'elaborazione dell'audio attiva, quattro delle nostre dieci condizioni di prova l'hanno superato: 150,8, 152,5, 159,5 e 163,3 ms, quelle con jitter simulato, con il 5 % di perdite o su TCP. La regola che ho fissato ora è 150 ms alla mediana su UDP con lo 0 e l'1 % di perdite, dove ogni condizione resta fra 111 e 131 ms, e 200 ms per quelle più dure. E la nostra rete simulata aggiunge 20 ms per verso, che una vera LAN d'ufficio non ha.
Cosa viene dopo
La prima chiamata vera fra due computer, che farò con e senza cuffie, e poi la finestra della chiamata. Windows e macOS. Poi i telefoni, in Wi-Fi: su Android il servizio che tiene vivo il microfono a schermo spento è già pronto. E più avanti un walkie-talkie: un messaggio vocale ascoltato mentre viene registrato, sulla LAN e via Bluetooth.